iOS群控,是指用一台电脑集中管理并批量操控多台 iPhone 的技术方案,免越狱、免签名、免硬件,靠外部输入注入驱动设备。
这篇要回答的是:iOS群控凌晨出的问题,早上怎么一次查清。
周一早上八点,一个人端着咖啡站到设备架前面。
那一排屏亮着,看起来跟平时没什么两样。他坐下打开中控,扫了一眼昨天晚上的任务记录——三条定时任务,两条状态正常,第三条写着失败,执行时间凌晨两点十分。
他做的第一件事是点开那条任务准备重跑。手指停了一下,因为他想起来上一次也是这么干的:重跑,看起来成功,中午才发现这一批设备上根本没有发出任何东西。
这次他换了个顺序;下面就是他那天按的顺序,从发现到处理完用了四十分钟。
先定性:是没发出去还是没人看
这两件事的表现几乎一样,你打开后台,数据没动。
但处置完全不同。没发出去是任务执行层面的问题,你手上能修;发了没人看是账号状态层面的问题,修设备没用。
区分方法很简单:随机挑两三台设备,打开对应的应用看内容本身在不在。
- 内容在,只是数据差 → 偏向账号状态,往下看第二段
- 内容根本不在 → 任务没跑成,往下看第三段
- 一部分在一部分不在 → 最麻烦的一种,是部分设备失败,看第四段
这一步两分钟,但它决定了后面所有的方向;很多人跳过它,直接去重跑,结果是把一个账号问题当成设备问题处理了两天;这一步跳过,后面能查到哪儿去?
圈范围,按设备而不是按账号
定范围:按设备分,不按账号分。 确定是任务没跑成之后,第二步是圈范围。
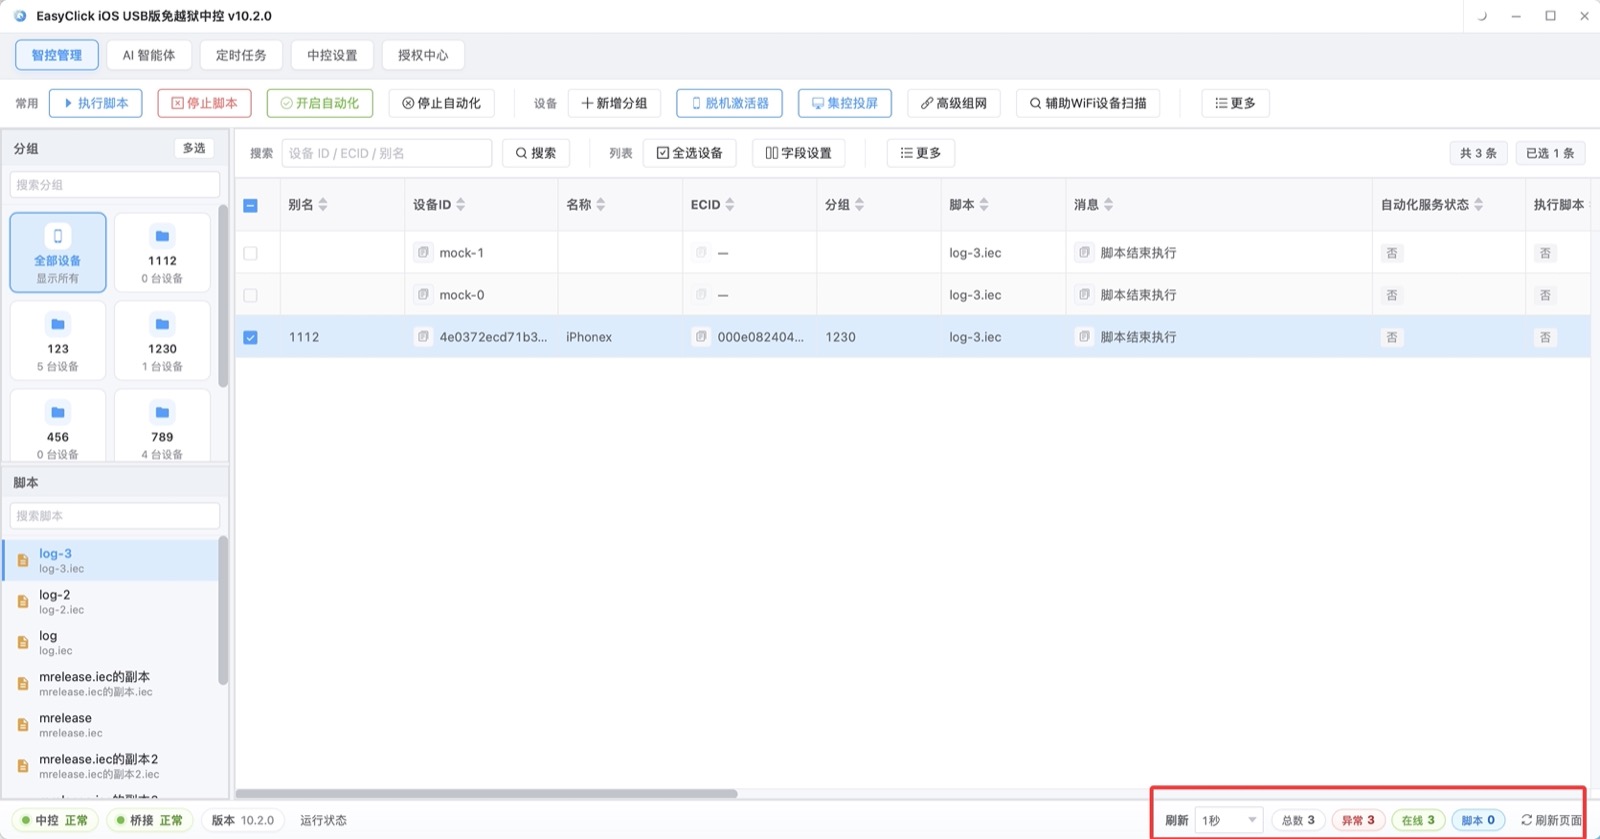
按设备分组看。 打开设备列表,把失败的设备单独列出来,看它们有没有共同特征:是不是同一个 HUB 上的、是不是同一根延长线、是不是同一批买的机型。
这一步的价值在于把「一批都失败」和「某几台失败」分开:
| 表现 | 更可能的原因 |
|---|---|
| 全部设备都失败 | 脚本本身、授权、或者中控侧的问题 |
| 只有同一 HUB 下的失败 | 供电或线材 |
| 只有某个机型失败 | 分辨率或系统版本差异 |
| 随机几台失败 | 单机状态(离线、掉授权、应用异常) |
按账号分为什么不行?因为账号会流动。今天在 A 组设备上跑的号,明天可能被分到 B 组,你按账号划出来的范围是一张网,不是一个圈。
翻日志看根因,再决定补不补
范围圈好之后,去把那几条失败任务的日志调出来。
看日志有个顺序:先看它停在哪一步,再看上一步是不是正常。
举个例子。如果日志显示失败在「点击发布按钮」这一步,你的第一反应可能是按钮找不到了;但正确的是往上看一步:上一步是「填写标题」。如果标题根本没填上,那点击失败只是结果,根因在填写那一步。
只看失败那一行,会一直在修症状。
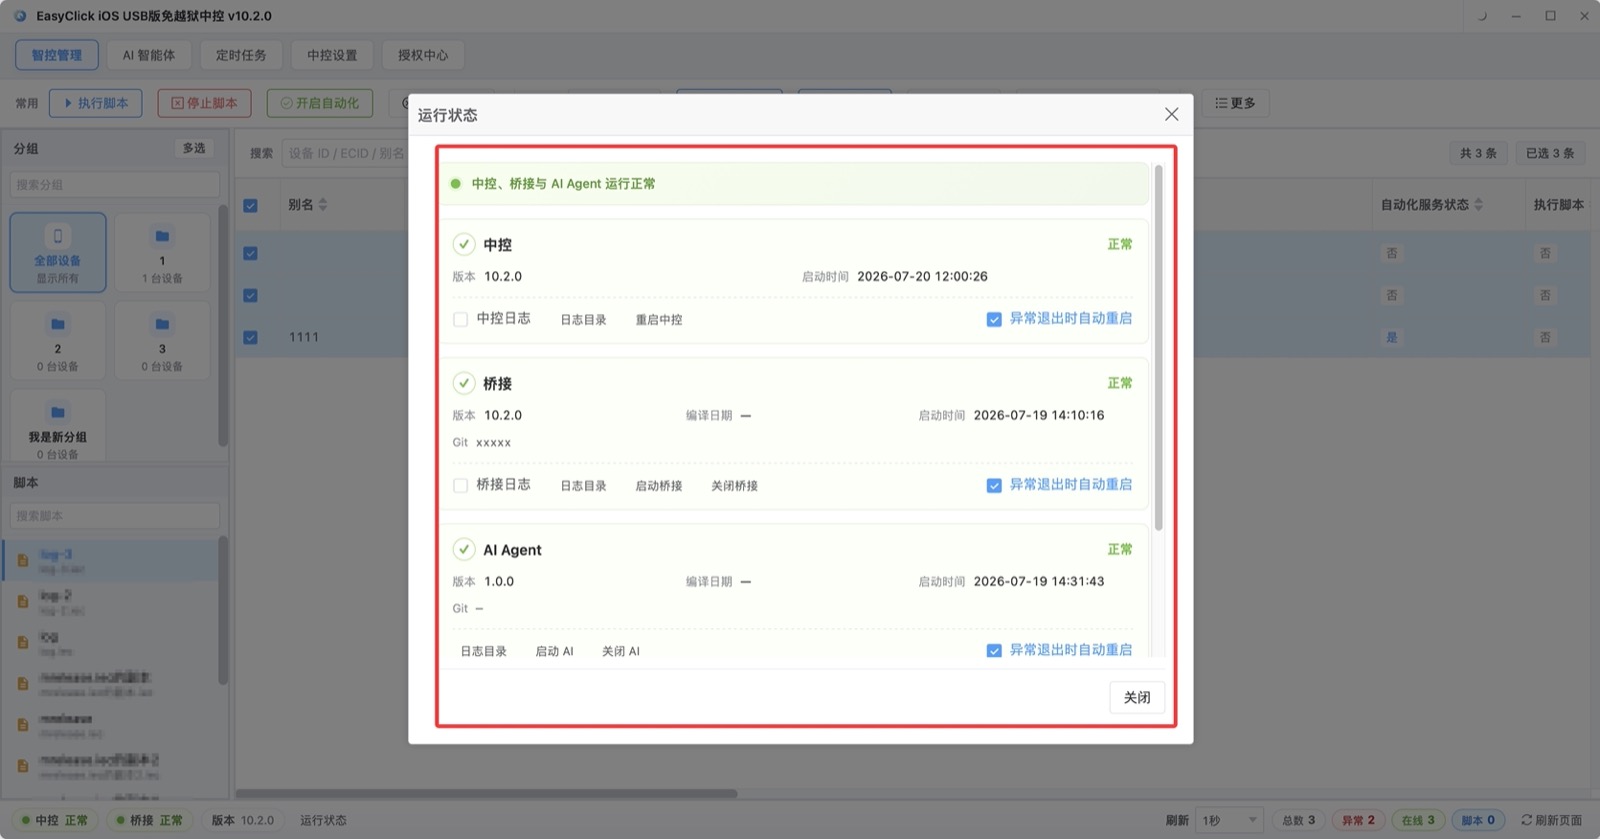
顺便说一个容易漏的地方:有些失败不会留下失败记录。 比如定时任务触发的那一刻,如果目标设备全都处于忙碌状态,这次触发会被直接跳过,中控里根本不会生成这条任务:错误只记在定时任务列表的「最近错误」一栏里。
所以「任务列表里什么都没有」也是一种情况,这时候要去定时任务列表里看,而不是在中控里找。
决定:补发还是等。 到这里你手上有三个信息:性质、范围、根因。然后才是决定补不补。
顺序不要反。判断逻辑是这样:
- 根因是环境问题(线材、供电、设备离线):先修环境,再补发。不修就补,会重复失败。
- 根因是脚本问题:改完脚本先在一台设备上单独试跑,确认这一台正常,再推全量。
- 根因是账号或平台侧问题:不要补发。这种情况补发等于把同一个动作再做一遍,只会加重问题。等两天观察,或者换一批设备试。
- 只是错过了时间窗口:如果这条内容有时效性(比如某个时点的活动),补发不如直接写新的。
有一条经验值得记住:补发的时候不要一次性推全量。 先补 10%,确认正常,再补剩下的;这样最坏的情况是浪费 10% 的量,而不是把整批又失败一次。
下次不用等到早上才发现
上面这一套是「已经出事了怎么办」;真正省事的是「出事的时候你能被叫醒」。
三件事,按性价比排:
第一件,把失败告警接上; 脚本里可以直接往群机器人发消息,任务失败就推送。这一步做完,你就不需要在早上八点才发现问题了:凌晨两点出事,两点你手机上就会响。
第二件,把定时任务的触发条件看清楚。 很多「任务没跑」的根子在这里:触发时间撞上了另一条任务,或者设备刚好在那个时间点上忙碌。把排期错开,问题就不会发生。
第三件,每台设备固定一个别名,并且在架子上贴对应的标签; 这一条跟告警无关,但跟处置速度关系很大。出事的时候你要在群里说「07 号那台有问题」,而不是「从左往右第四台」,后者说出去没人知道是哪台。
回到周一早上那四十分钟。
那位最后发现的原因是:第三条任务用的那台设备,前一天下午被拔过线做测试,插回去的时候接到了另一个 HUB 上,而那个 HUB 的供电在夜里出过一次波动。
修的是环境,不是脚本。改完之后他做了两件事:给每个 HUB 贴了编号,把失败告警接到了手机上。
凌晨出问题这件事没法完全避免;能控制的是你什么时候知道、以及知道之后按什么顺序处理。 把顺序固定下来,大多数情况四十分钟能收掉;顺序反了,就是两天。